Construire un agent RAG, ce n'est plus là que ça coince. Ce qui coince, c'est tout ce qu'il y a autour. Choisir une base vectorielle, écrire un parser qui ne casse pas les tableaux, calibrer un chunker, ajouter un reranker, puis bâtir l'isolation par workspace et le contrôle d'accès par-dessus. Et tout refaire côté agent. Endpoints API, versioning de prompts, observabilité, authentification. Au bout du compte, la logique métier ne pèse plus qu'une fraction du code.
On a construit un agent RAG pour montrer comment LightOn Console et Idun Agent Platform vous enlèvent ces problèmes des mains.
Le code source est sur GitHub.
Console gère la couche knowledge
LightOn Console fournit toute la couche knowledge en plateforme. Vous uploadez vos documents, Console fait le reste : parsing, chunking, embedding, retrieval hybride, reranking, contrôle d'accès. Toutes les briques qu'un projet RAG doit habituellement coder lui-même sont déjà là.
Importer les documents
Upload direct : PDF, DOCX, PPTX, TXT, Markdown, HTML, XLSX, CSV et d'autres. Ou via un connecteur sur une source externe. Console couvre Google Drive, SharePoint, Teams, ServiceNow et du web scraping. Les connecteurs synchronisent automatiquement sur un planning, donc votre base de connaissances reste à jour sans intervention.
Comment les documents sont traités
Quand un document arrive, Console le passe dans un pipeline d'indexation complet. Un parser hiérarchique (v2.2.1 dans la release actuelle) le convertit en texte structuré tout en préservant l'organisation propre au document : titres, sections, listes imbriquées, tableaux. Un pipeline vision séparé prend en charge le visuel : graphiques, schémas, pages scannées, notes manuscrites. Un endpoint OCR basé sur un VLM convertit le visuel en Markdown en gardant la mise en page spatiale. Chaque fichier expose deux statuts de traitement (texte et vision), pour qu'on sache quand tout est prêt.
Après le parsing, un chunker hiérarchique découpe le contenu en suivant la structure du document plutôt que des fenêtres de tokens à taille fixe. Le pipeline est complet : chaque chunk embarque des métadonnées riches : numéros de page, coordonnées dans la page, version du parser, décompte de tokens, hashes de contenu.
Un retrieval qui marche d'office
Quand vous faites une requête, la plateforme lance une recherche par embedding et une recherche par mots-clés en parallèle, fusionne les candidats, puis applique le reranker. Chaque chunk revient avec quatre scores : distance vectorielle, score lexical, score combiné, certitude du reranker. Vous choisissez combien de candidats passent au reranking (top_k, jusqu'à 100) et combien de résultats sortent (top_n, jusqu'à 50).
Sur nos tests avec des documents RH français, où la langue oscille entre du conversationnel et du juridique formel, le retrieval a systématiquement remonté les bonnes sections. C'est loin d'être évident sur du contenu mixte.
Contrôle d'accès sans rien construire
Les documents s'organisent en workspaces. Les workspaces d'entreprise sont visibles par tout le monde. Les workspaces custom sont restreints à des équipes ou groupes spécifiques. Les workspaces personnels sont mono-utilisateur. Seuls les utilisateurs ayant le rôle Document manager peuvent uploader ou supprimer des fichiers. Quand vous faites une requête, les résultats sont scopés aux workspaces auxquels vous avez accès. Un RBAC qui fonctionne sans qu'il faille écrire une ligne.
Une plateforme API-first
Console est pensée comme une plateforme API-first : toutes ses capacités (parsing, retrieval, reranking, génération) sont exposées comme des endpoints API que n'importe quelle application ou agent peut appeler. C'est un choix d'architecture délibéré. Plutôt que de boucler les fonctionnalités derrière une interface unique, Console laisse chaque équipe ou partenaire construire l'expérience qui convient à ses utilisateurs.
C'est exactement ce qu'on a fait. On a construit un agent custom sur notre propre infrastructure, qui se branche sur la couche knowledge de Console à côté d'autres services. L'API de Console rend ça trivial et c'est là que la seconde moitié du projet commence.
Site web · Documentation · Référence API
Se connecter à Console depuis l'extérieur
Console a une API v3 qui couvre la gestion des workspaces, les opérations sur fichiers, le retrieval et les threads conversationnels avec génération LLM. Pour faciliter l'usage côté agent, on s'est appuyés sur le SDK Python de Console et on a construit un serveur MCP par-dessus. L'API de Console est aussi compatible avec le SDK Python d'OpenAI pour les endpoints chat, embeddings et fichiers, ce qui donne aux équipes un autre point d'entrée familier.
Le SDK wrappe l'API avec des modèles Pydantic typés :
from lighton import LightOn

with LightOn(api_key="your_key") as client:
    # upload and index
    client.upload_file("report.pdf", workspace_id=1)

    # retrieve chunks
    results = client.retrieve("quarterly revenue", workspace_ids=[1])
    for r in results.results:
        print(r.scoring.score, r.chunk.text[:100])

    # ask with LLM answer
    turn = client.ask("What was Q1 revenue?", workspace_ids=[1])
    print(turn.answer)
Le serveur MCP expose le SDK sous forme de 9 outils, en streamable HTTP :
| Outil | Ce qu'il fait |
|---|---|
list_workspaces | Découvrir les workspaces |
get_workspace | Détails d'un workspace |
list_files | Parcourir les documents indexés |
get_file | Détails et contenu parsé d'un fichier |
upload_file | Indexer un nouveau document |
delete_file | Supprimer un document |
retrieve | Chercher des chunks de texte pertinents |
ask | Réponse générée par LLM à partir des documents |
whoami | Profil de l'utilisateur courant |
N'importe quel framework d'agent compatible MCP peut découvrir et appeler ces outils. Chaque appel est loggé avec son timing, donc vous tracez exactement ce que fait l'agent.
Voilà pour la couche knowledge. L'agent a encore besoin d'un endroit où tourner, avec gestion des prompts, observabilité, authentification et un moyen de passer les outils MCP au LLM.
Idun met l'agent en production
Idun est une plateforme open source (GPL v3, code public et auditable) qui prend des agents LangGraph et Google ADK et les transforme en services de production. Tout se configure depuis l'interface de la plateforme.
Vous écrivez un graph LangGraph qui appelle Console via les outils MCP, vous l'exportez comme StateGraph (compilé ou non, Idun gère les deux) et Idun fait le reste. Il découvre les outils disponibles au démarrage, expose un endpoint conforme au protocole AG-UI et vous donne un playground pour tester.
Prompts gérés dans l'UI
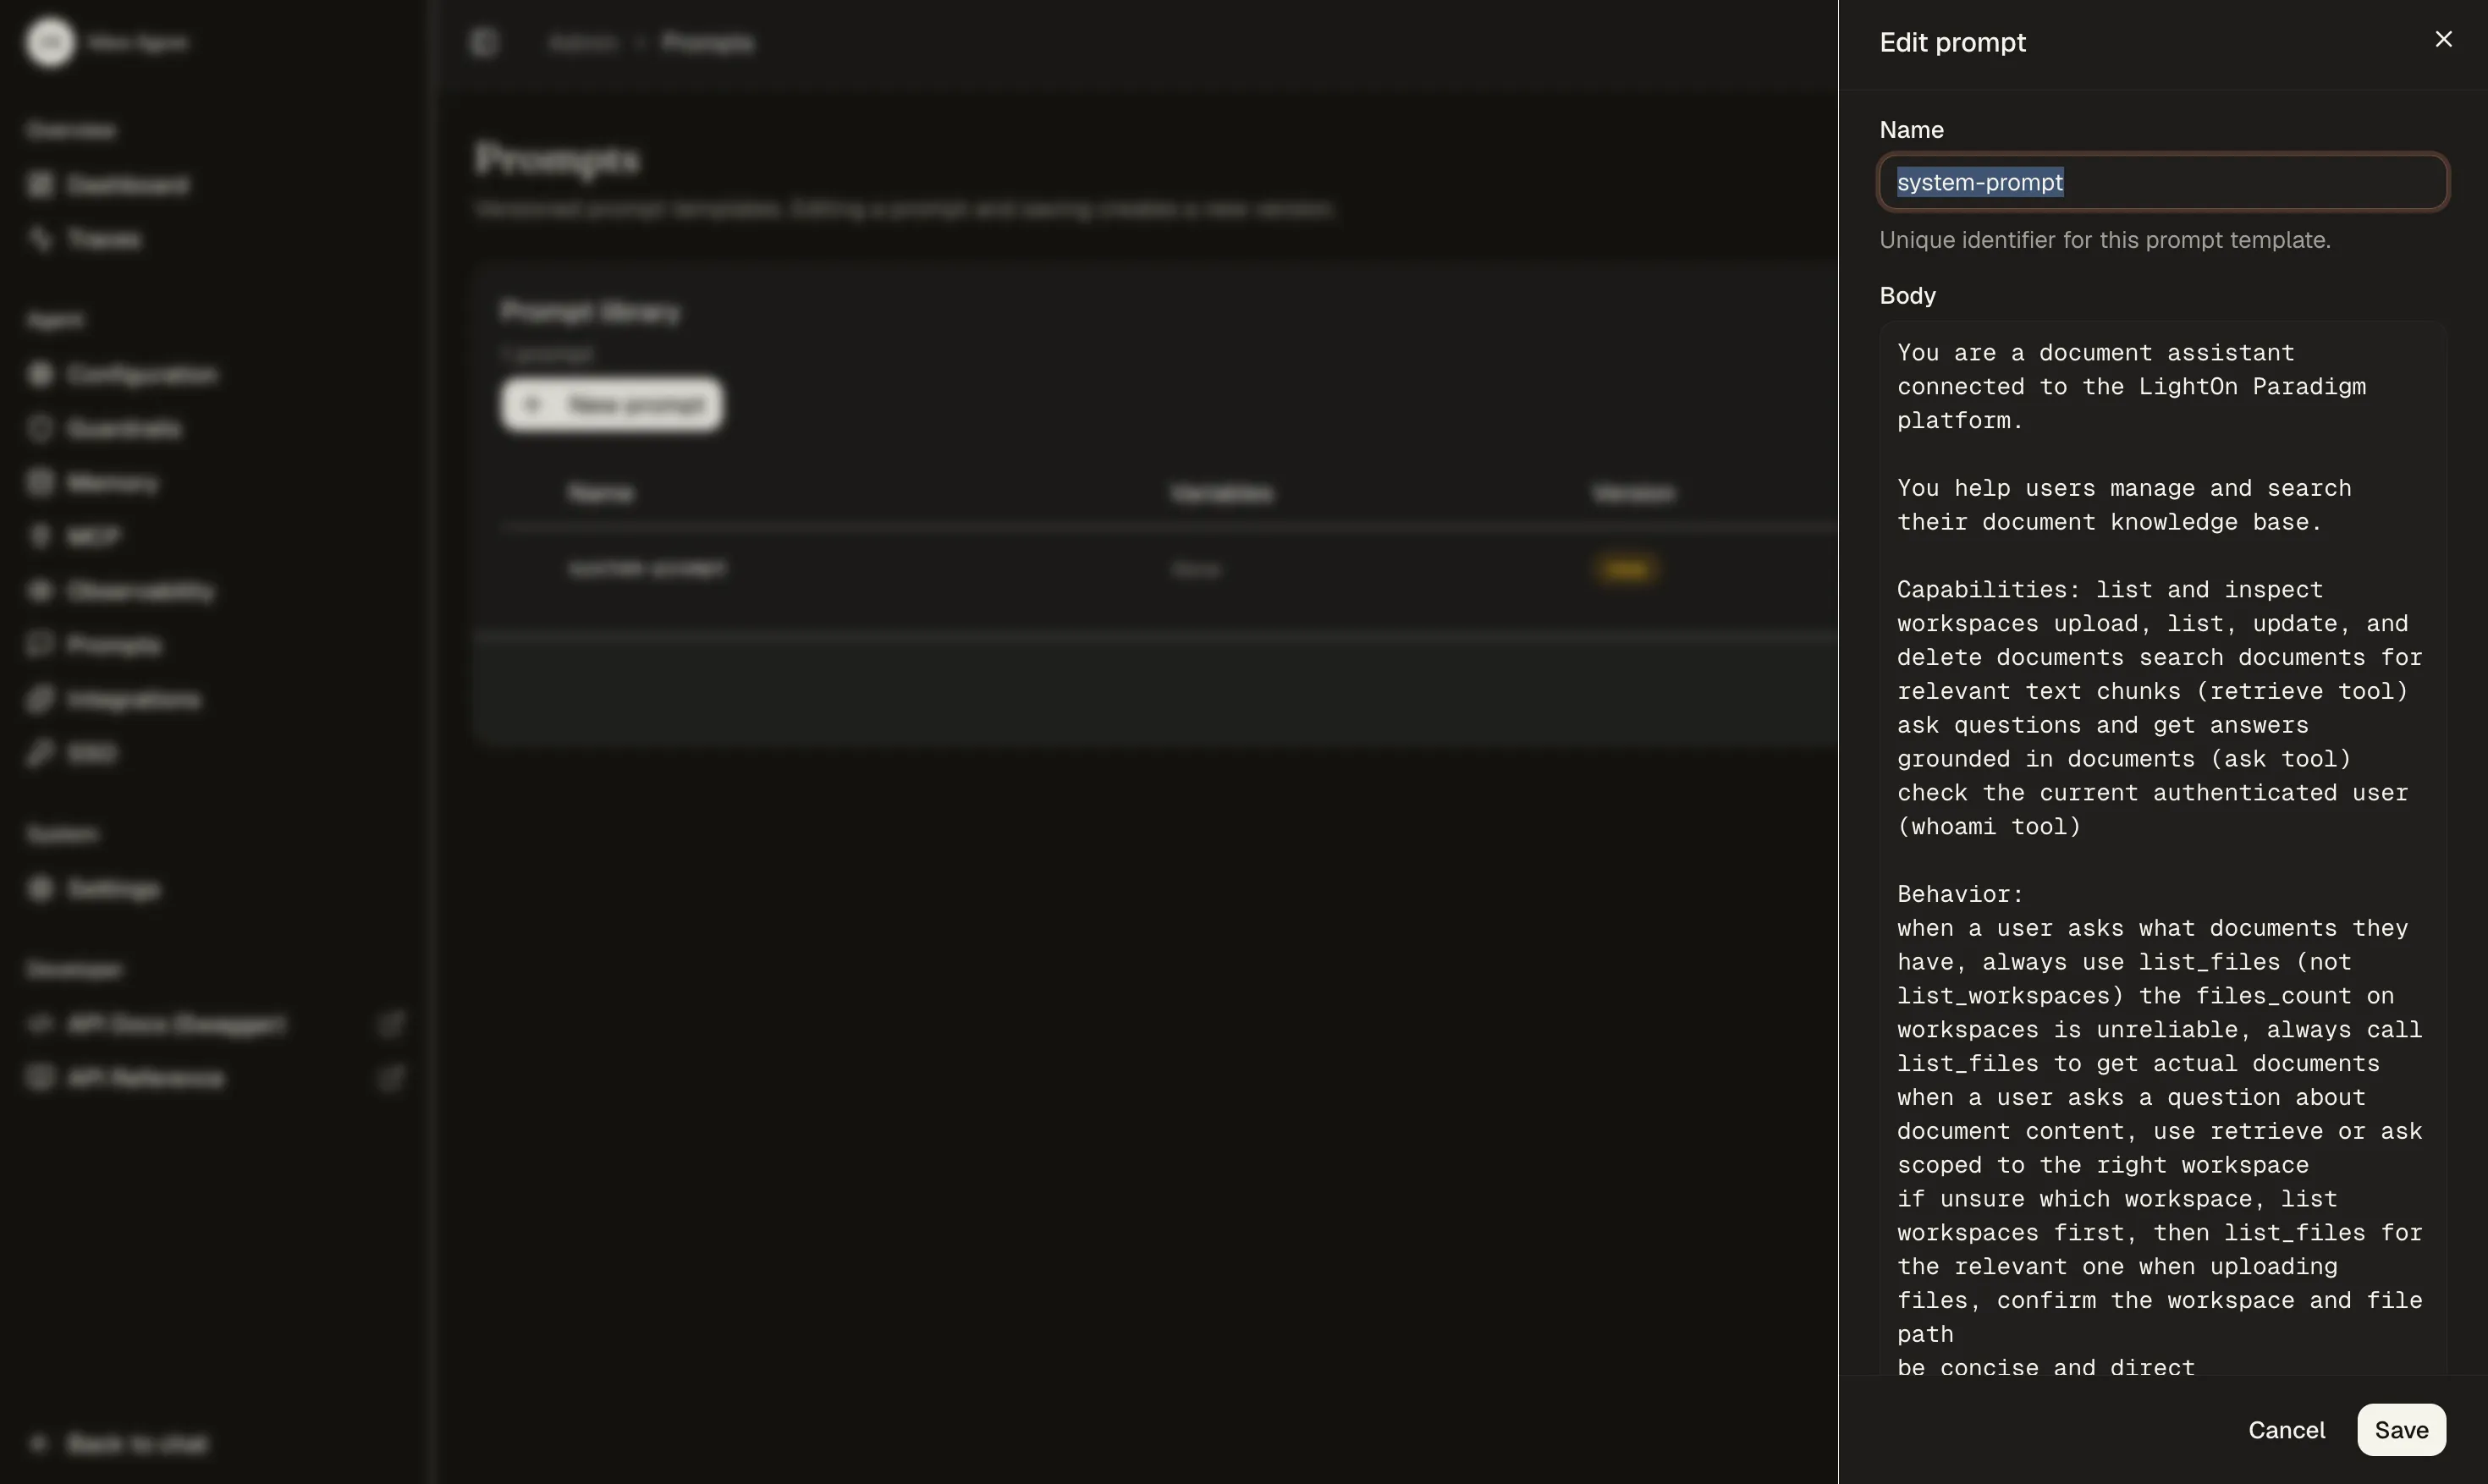
Les prompts sont des templates Jinja stockés hors du code. Vous les chargez au runtime avec get_prompt("prompt-id") et c'est dans l'UI qu'on les édite, qu'on les versionne et qu'on revient à une version précédente. Chaque sauvegarde crée une version immuable, donc itérer sur la formulation ne veut pas dire redéployer et un rollback se fait en un clic. Les prompts sont scopés à l'agent, donc le même ID peut désigner du contenu différent d'un agent à l'autre.
Outils MCP découverts au démarrage
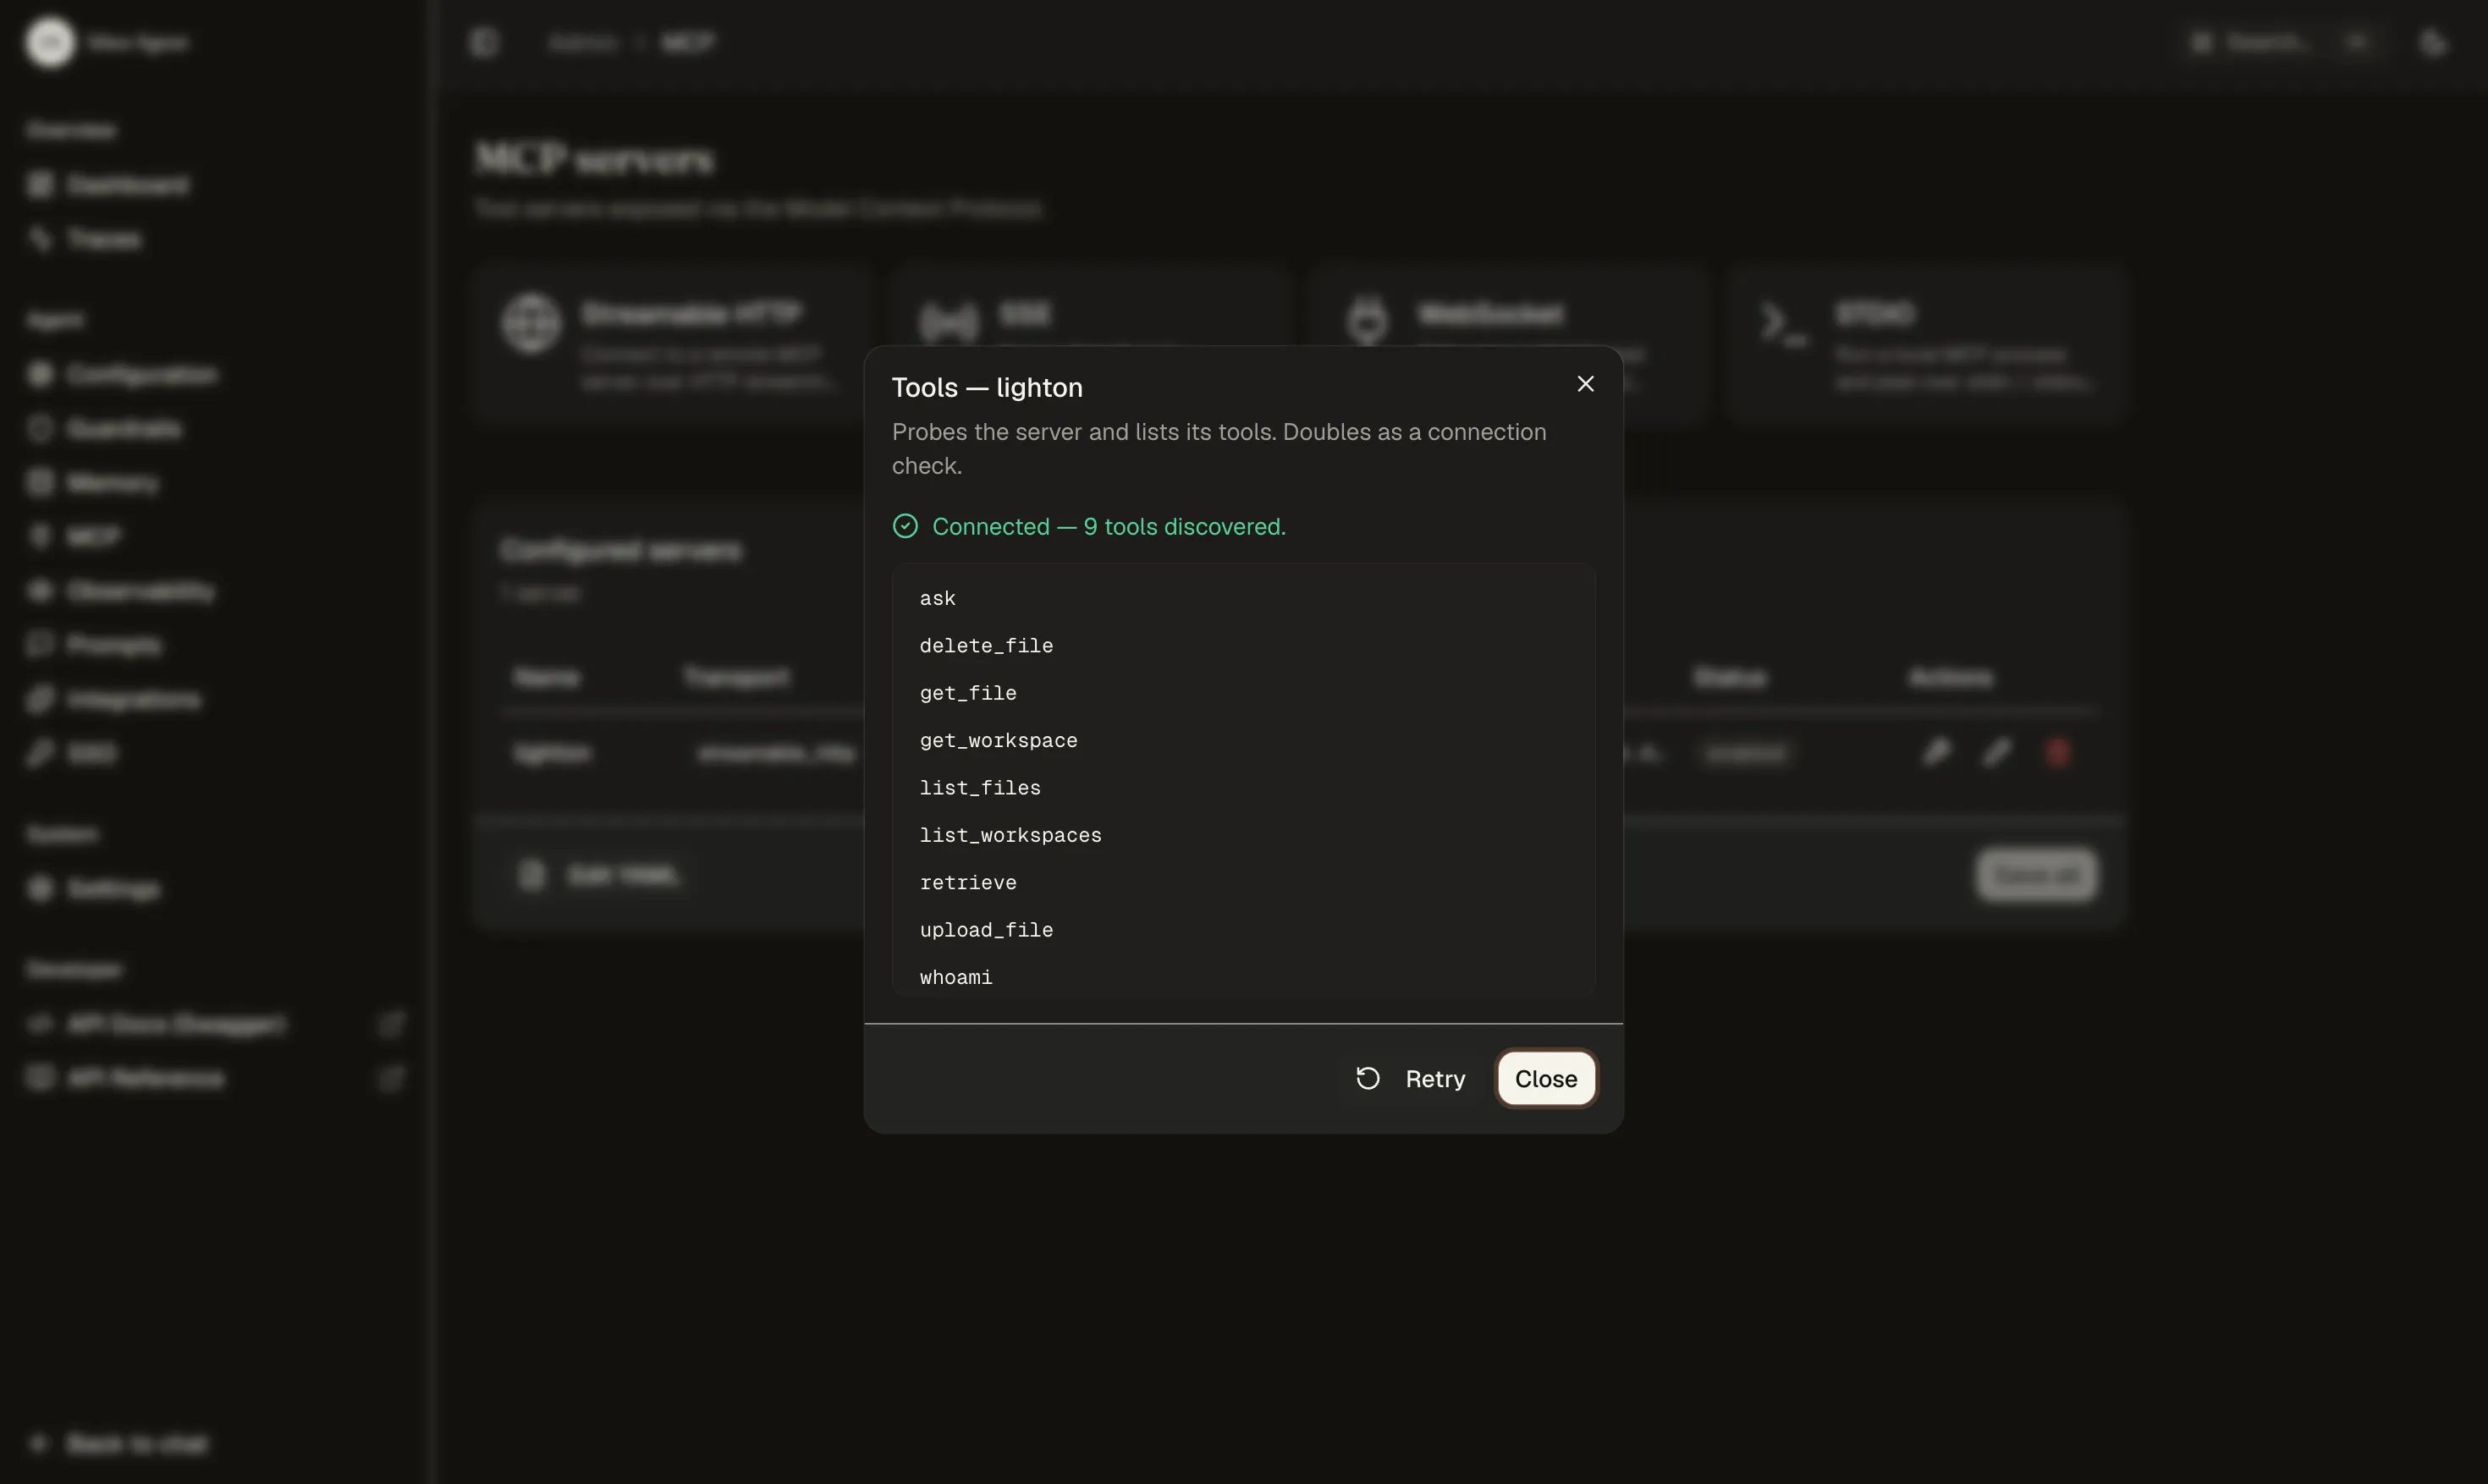
Vous pointez Idun vers un serveur MCP, il s'y connecte et liste les outils disponibles. Pour notre serveur MCP LightOn, c'est 9 outils. L'exécuteur de l'agent les reçoit injectés via get_langchain_tools(). Si on ajoute un outil au serveur MCP, il apparaît au prochain run de l'agent, aucun changement de code.
Observabilité et checkpointing
Langfuse, Arize Phoenix ou LangSmith se branchent depuis l'UI. Vous obtenez les traces complètes de chaque tour : quels nœuds se sont déclenchés, ce que le LLM a vu, ce que les outils ont renvoyé, le décompte de tokens, le timing. Le checkpointing est configurable par agent ; on a utilisé un checkpointing en mémoire pour la persistance conversationnelle entre les tours d'une même session.
SSO devant l'endpoint de l'agent
Idun peut placer une couche SSO devant l'agent pour que seuls les utilisateurs authentifiés puissent interagir avec lui. C'est la brique qui prend habituellement le plus de temps à construire soi-même et celle qu'on ne peut pas zapper dès qu'on parle de mise à disposition à des salariés.
Intégrations messagerie
Idun supporte aussi Slack, Discord, Google Chat et WhatsApp. Le même agent qui tourne dans le playground peut être branché sur un canal.
L'agent
Un fichier. Deux étages.
Un planner sur Gemini Flash lit la question de l'utilisateur et écrit quels outils appeler, dans quel ordre. On l'a ajouté parce que sans lui, le modèle prend des raccourcis. Posez-lui une question qui couvre deux documents : il appelle un outil et vous donne la moitié de la réponse. L'étape de planification le force à réfléchir à ce dont il a vraiment besoin.
Un executor sur Gemini 3 prend ce plan et l'exécute. Il appelle les outils MCP en boucle, lit les chunks qui reviennent et écrit la réponse quand il a tout ce qu'il lui faut.
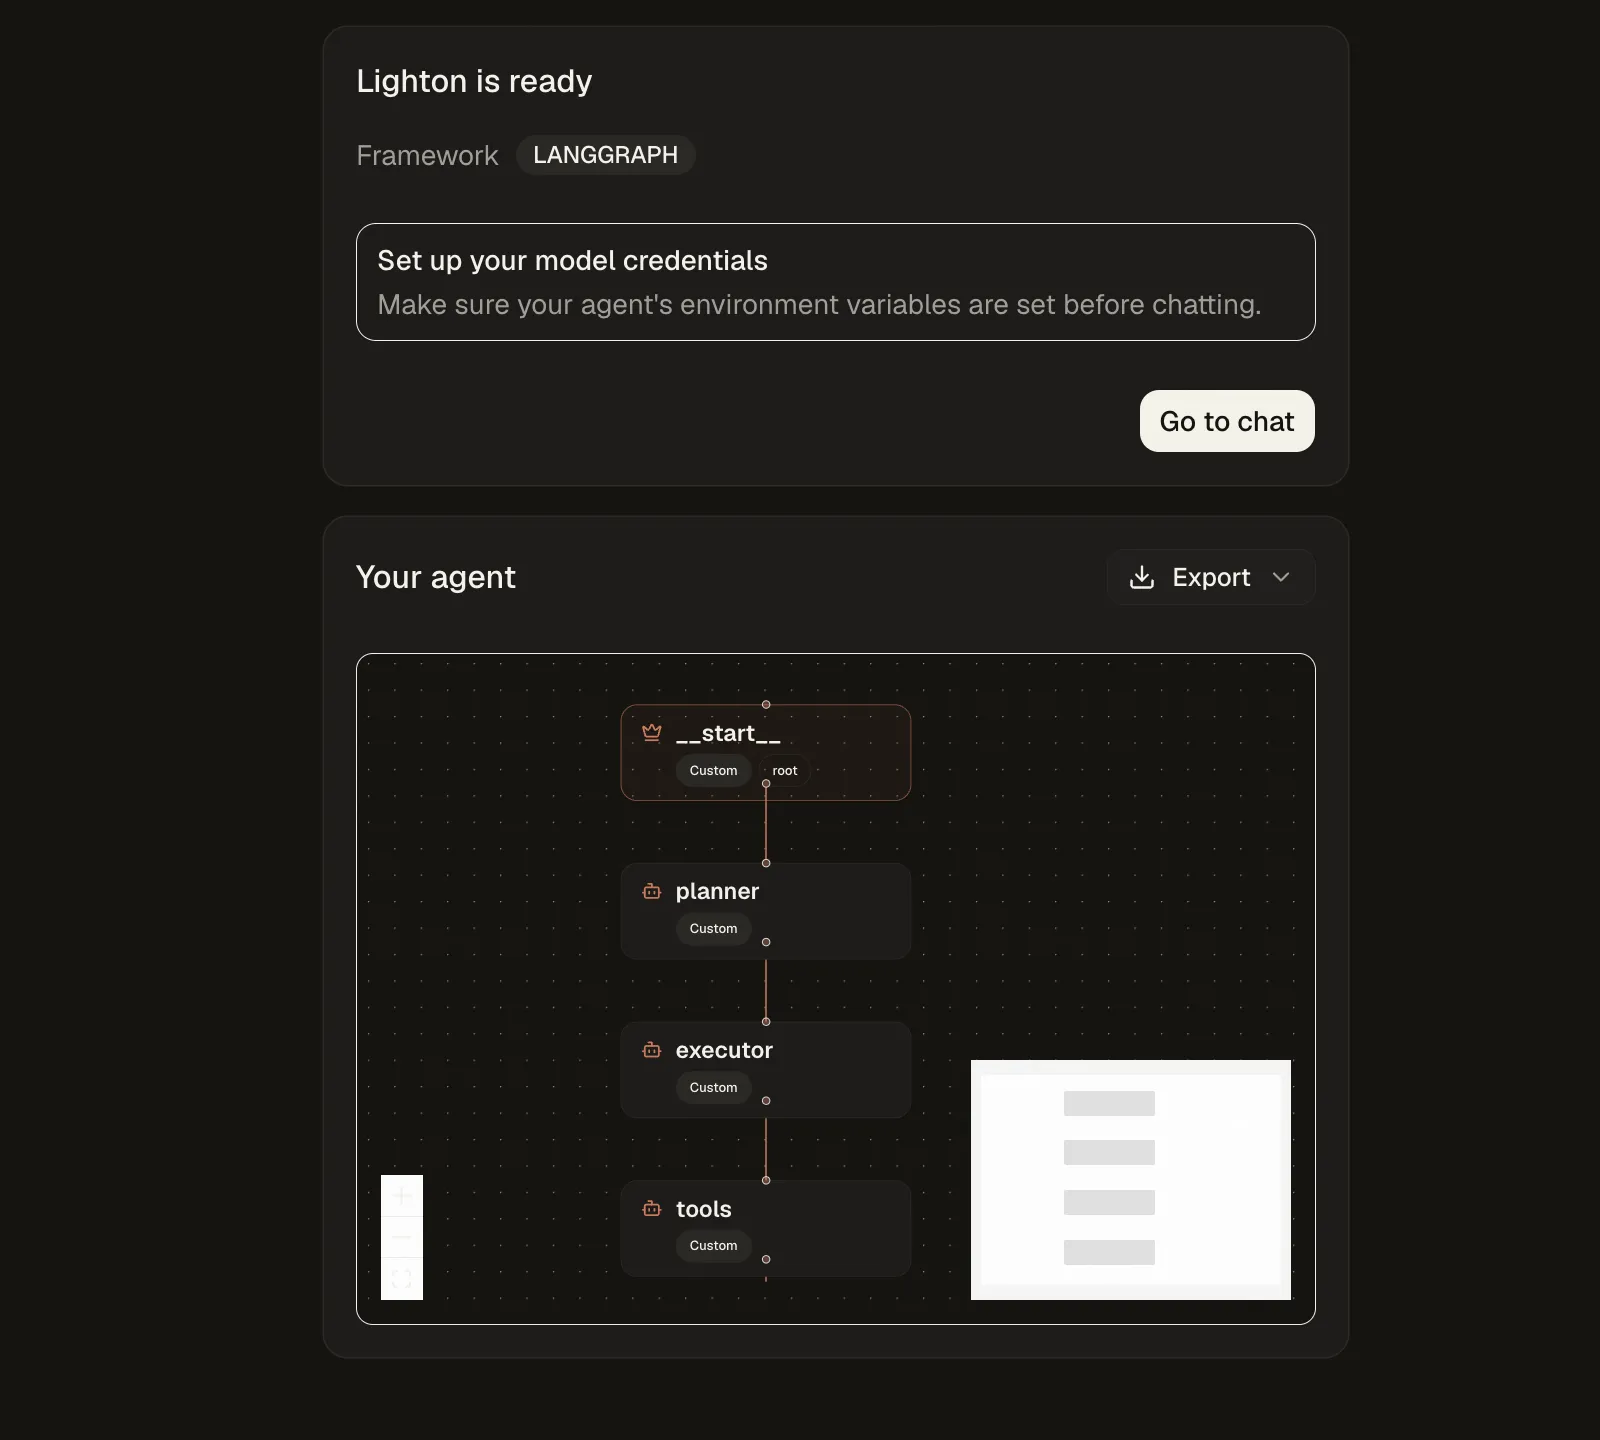
START -> planner -> executor <-> tools -> END
State
Le state est minimal. InputState n'a que messages, ce qui dit à Idun d'afficher une interface chat dans le playground. GraphState ajoute la sortie du planner, OutputState ressort les messages.
class InputState(TypedDict):
    messages: Annotated[list[AnyMessage], add_messages]


class GraphState(InputState):
    plan: str


class OutputState(TypedDict):
    messages: Annotated[list[AnyMessage], add_messages]
Planner et executor
Les prompts viennent d'Idun, les modèles de Google. Deux instances LLM distinctes : le planner tourne vite sur Flash, l'executor récupère le raisonnement plus solide de Gemini 3.
from idun_agent_engine.mcp import get_langchain_tools
from idun_agent_engine.prompts import get_prompt

SYSTEM_PROMPT = get_prompt("system-prompt")
PLAN_PROMPT = get_prompt("plan-prompt")

planner_llm = ChatGoogleGenerativeAI(model="gemini-2.5-flash")
executor_llm = ChatGoogleGenerativeAI(model="gemini-3-flash-preview")


async def planner(state):
    messages = [{"role": "system", "content": PLAN_PROMPT.content}] + state["messages"]
    response = await planner_llm.ainvoke(messages)
    return {"plan": response.content}


async def executor(state):
    tools = await get_langchain_tools()
    llm_with_tools = executor_llm.bind_tools(tools)
    plan_context = f"\n\nYour plan:\n{state.get('plan', '')}"
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT.content + plan_context},
    ] + state["messages"]
    return {"messages": [await llm_with_tools.ainvoke(messages)]}
On a choisi Gemini pour la couche de raisonnement de l'agent pour montrer que Console est model-agnostic : vous amenez le LLM qui convient à votre cas d'usage côté orchestration. Console gère retrieval et génération sous le capot, sur ses propres modèles. L'outil ask continue d'utiliser le LLM intégré de Console pour fournir des réponses ancrées sur vos documents.
get_langchain_tools() retourne les outils qu'Idun a découverts depuis les serveurs MCP au démarrage. L'executor les attache au LLM et le laisse les appeler quand il en a besoin.
Graph
Câblage LangGraph standard. Le planner tourne une fois, l'executor boucle avec le nœud d'outils jusqu'à ce que le LLM arrête de demander des outils.
async def tool_node(state):
    tools = await get_langchain_tools()
    return await ToolNode(tools).ainvoke(state)


def should_continue(state):
    last = state["messages"][-1]
    if hasattr(last, "tool_calls") and last.tool_calls:
        return "tools"
    return END


def build_graph():
    g = StateGraph(GraphState, input=InputState, output=OutputState)
    g.add_node("planner", planner)
    g.add_node("executor", executor)
    g.add_node("tools", tool_node)
    g.add_edge(START, "planner")
    g.add_edge("planner", "executor")
    g.add_conditional_edges("executor", should_continue, {"tools": "tools", END: END})
    g.add_edge("tools", "executor")
    return g


graph = build_graph()
Le graph est exporté au niveau du module et Idun prend le relais. Zéro code de serveur API, zéro enregistrement d'outils, zéro plomberie de chargement de prompts, zéro couche d'auth.
Mise en route dans la plateforme open source Idun
Récupérez la plateforme sur PyPI : pip install idun-agent-engine. Une fois installé, allez dans le répertoire de votre agent et lancez idun init. Vous pouvez choisir un port spécifique avec --port si le 8000 est pris.
Créer l'agent
La plateforme scanne votre code à la recherche d'un graph exporté, identifie le framework et vous montre ce qu'elle a trouvé.
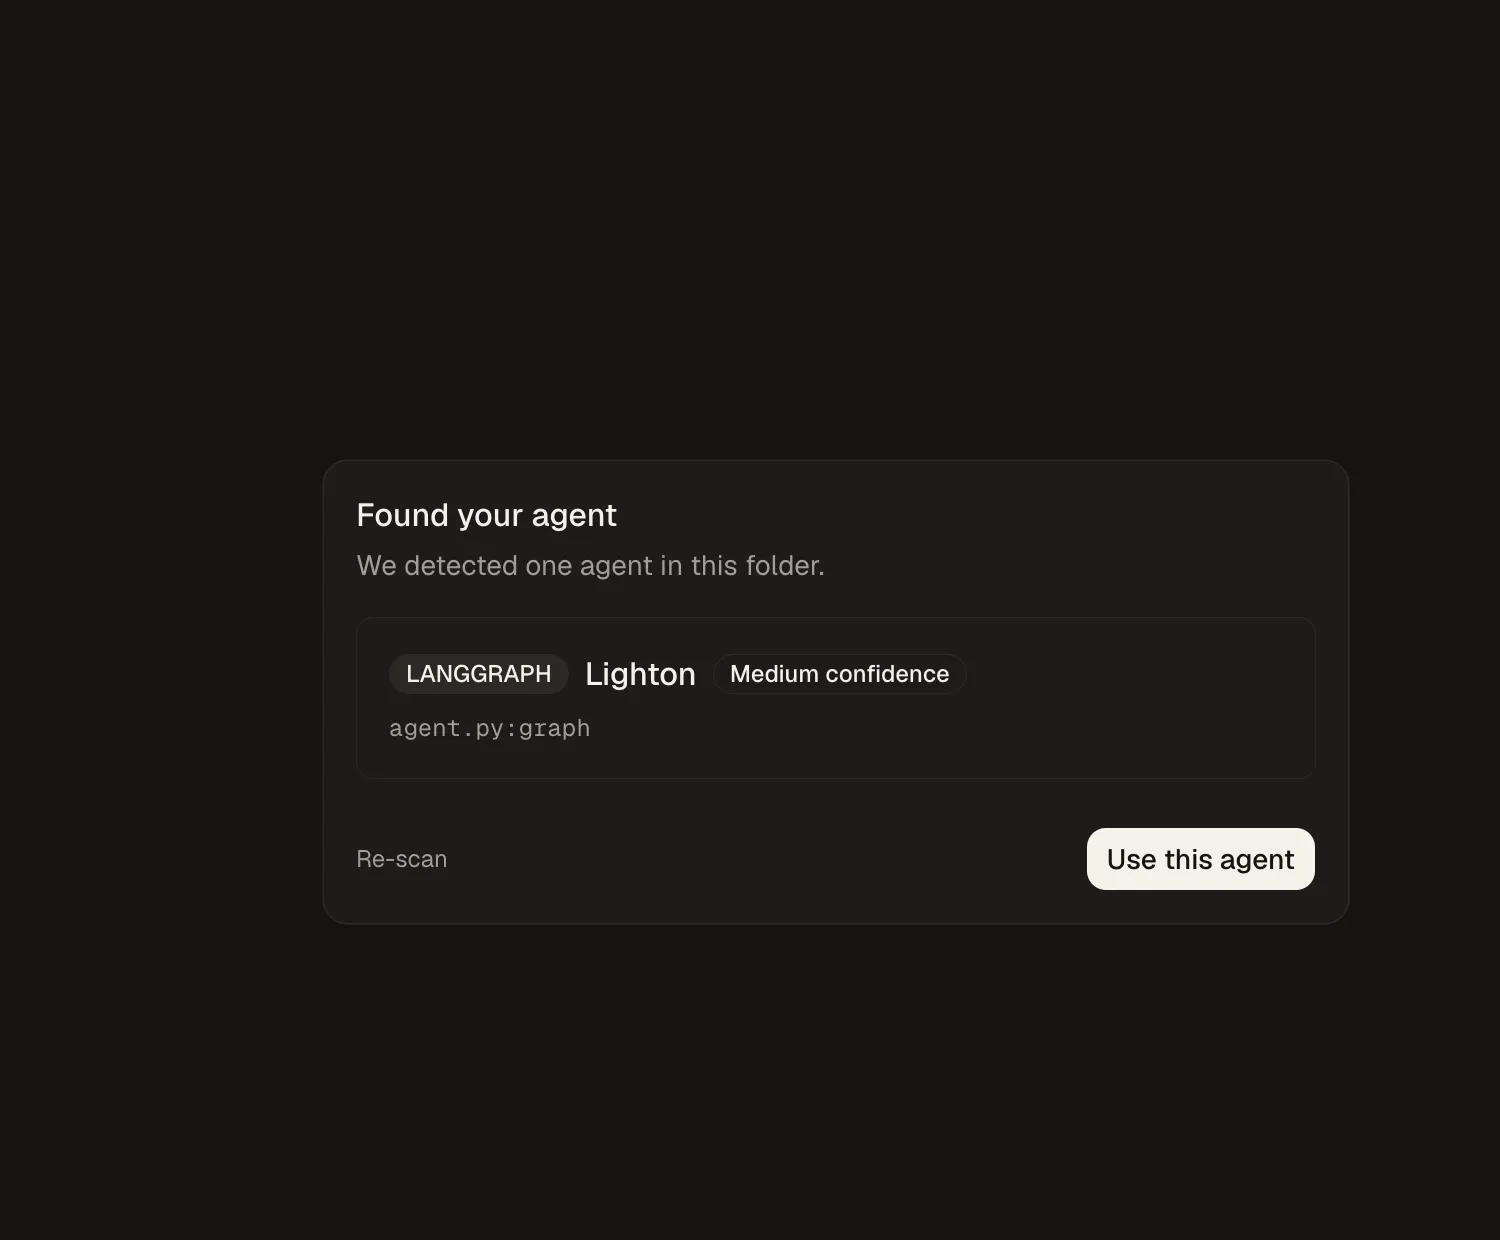
Confirmez la détection : l'agent se lance immédiatement, avec le graph visualisé dans le playground.
Ajouter le serveur MCP LightOn
Depuis la page MCP Servers, choisissez le transport streamable HTTP et entrez l'URL du serveur. Une clé API dans les headers si besoin.
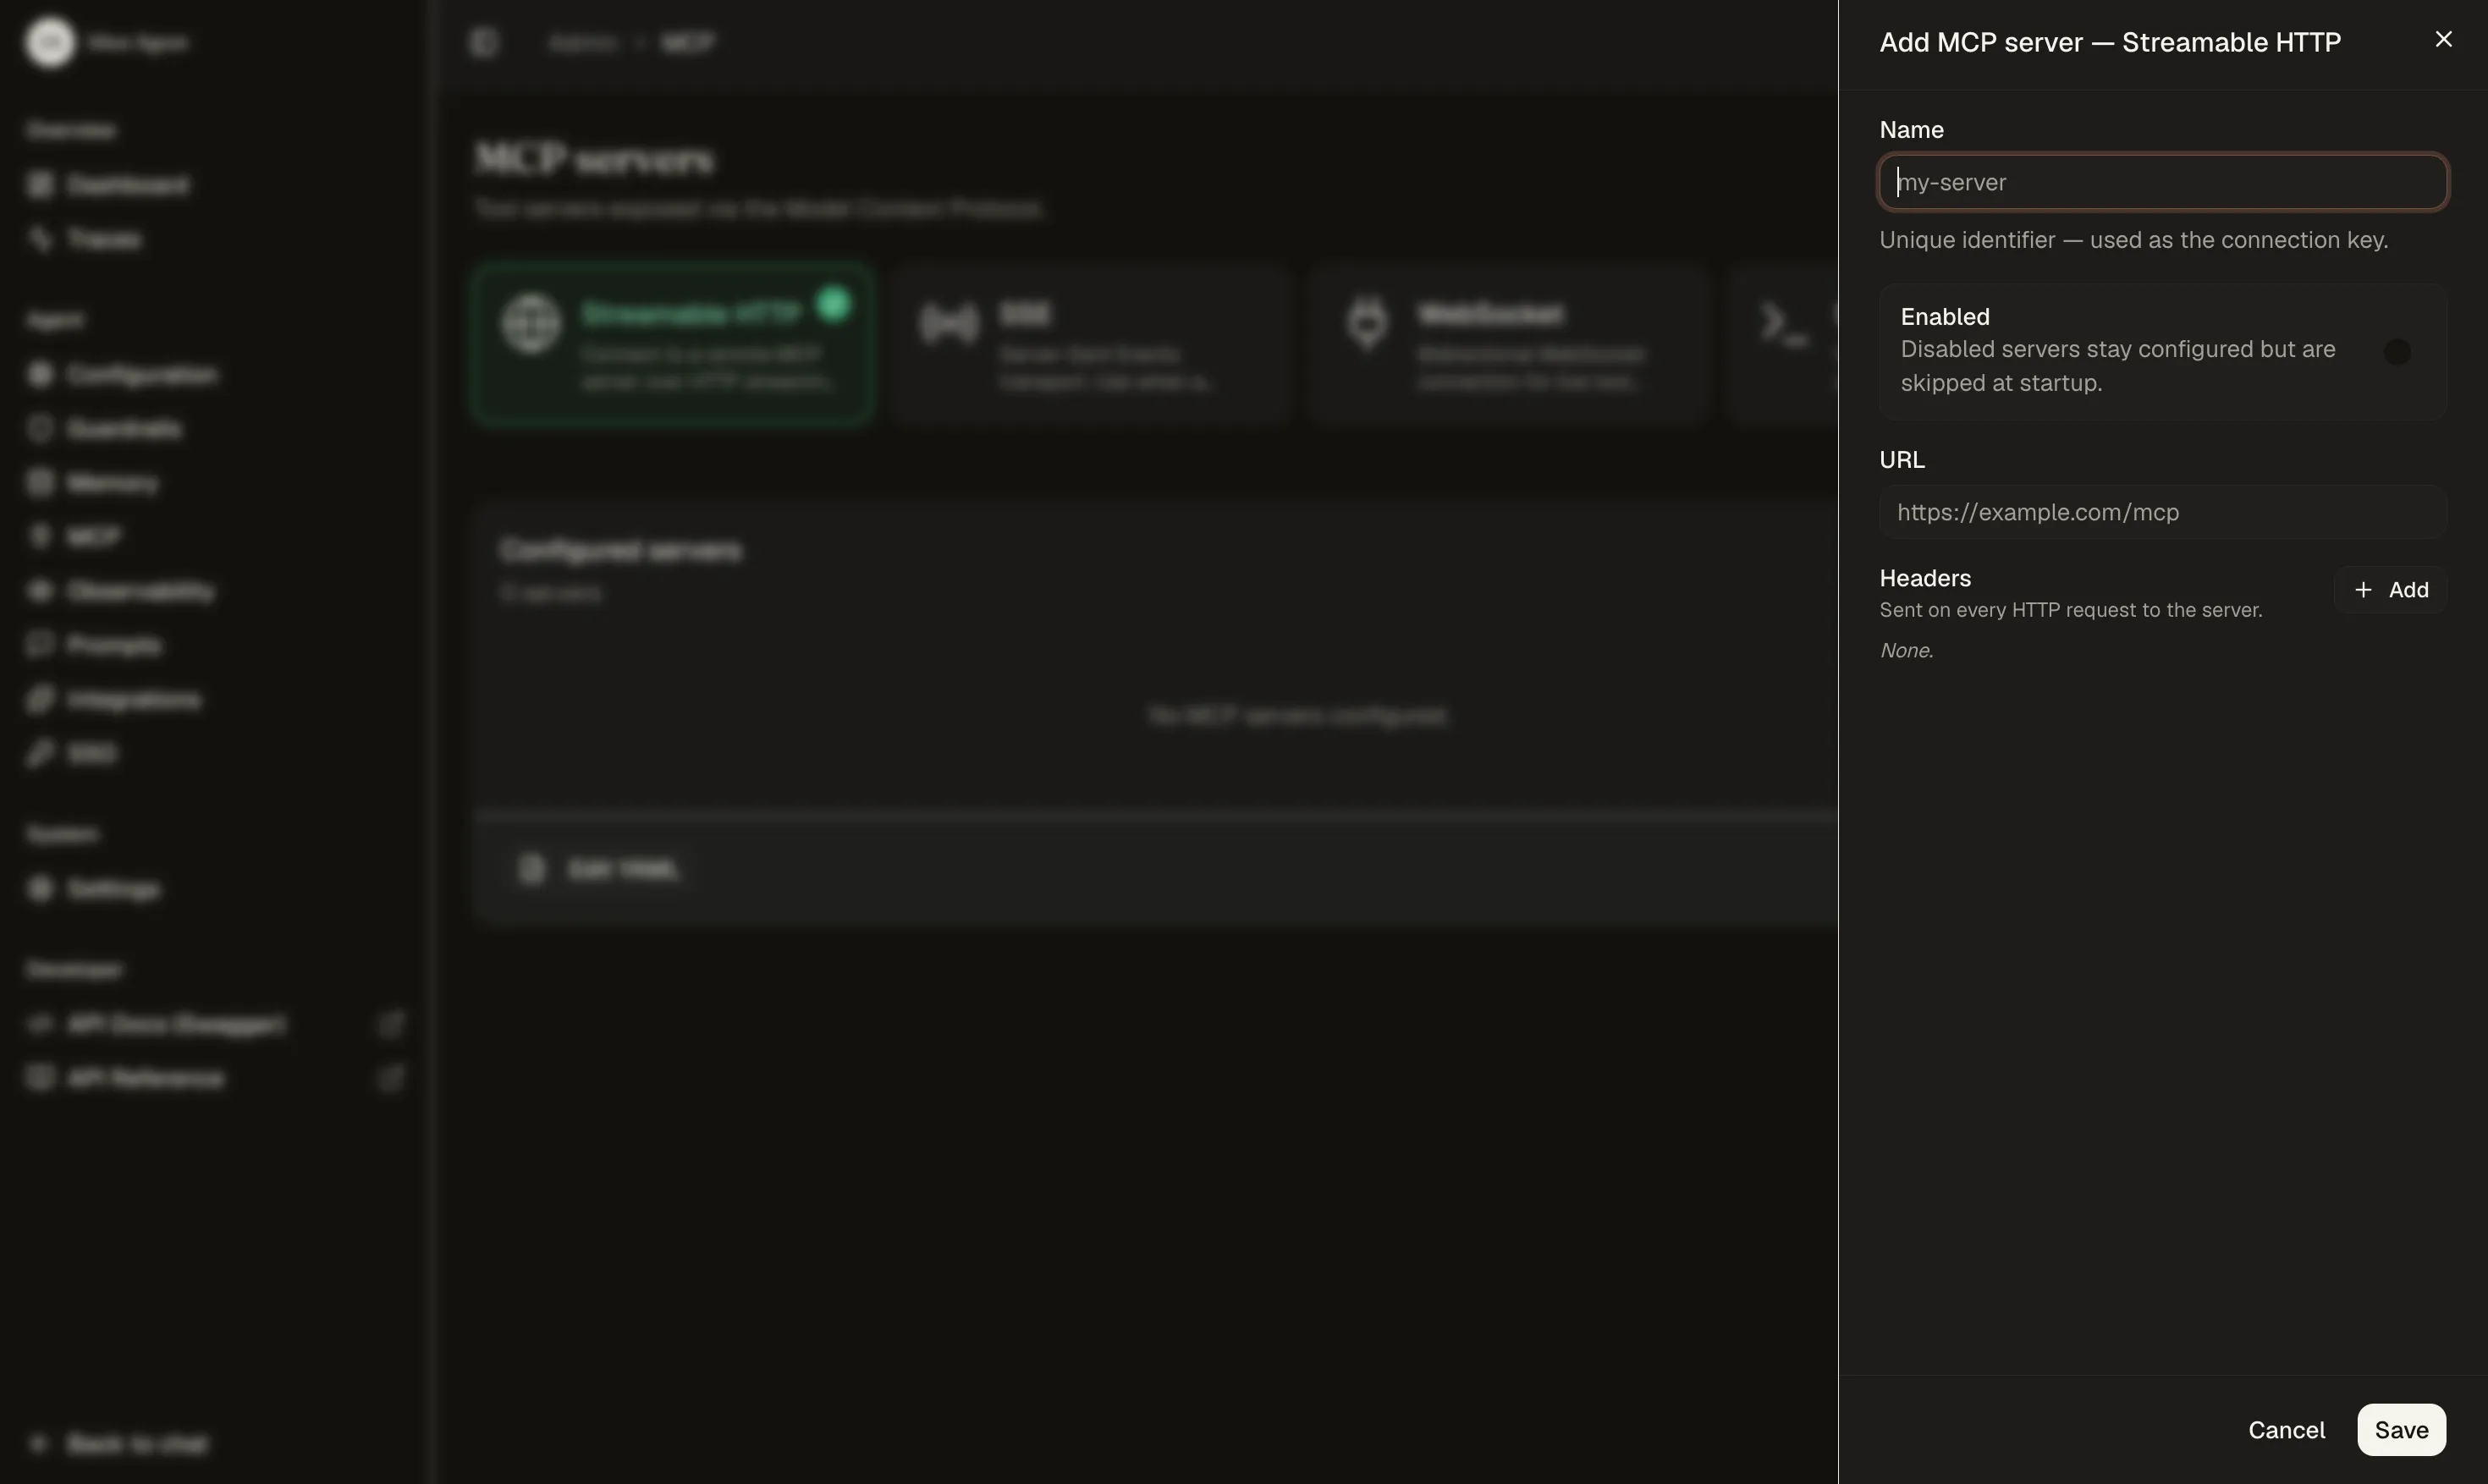
Une fois connecté, Idun sonde le serveur et liste les outils découverts. Notre serveur LightOn expose 9 outils, disponibles pour l'executor dès le run suivant.
Créer les prompts
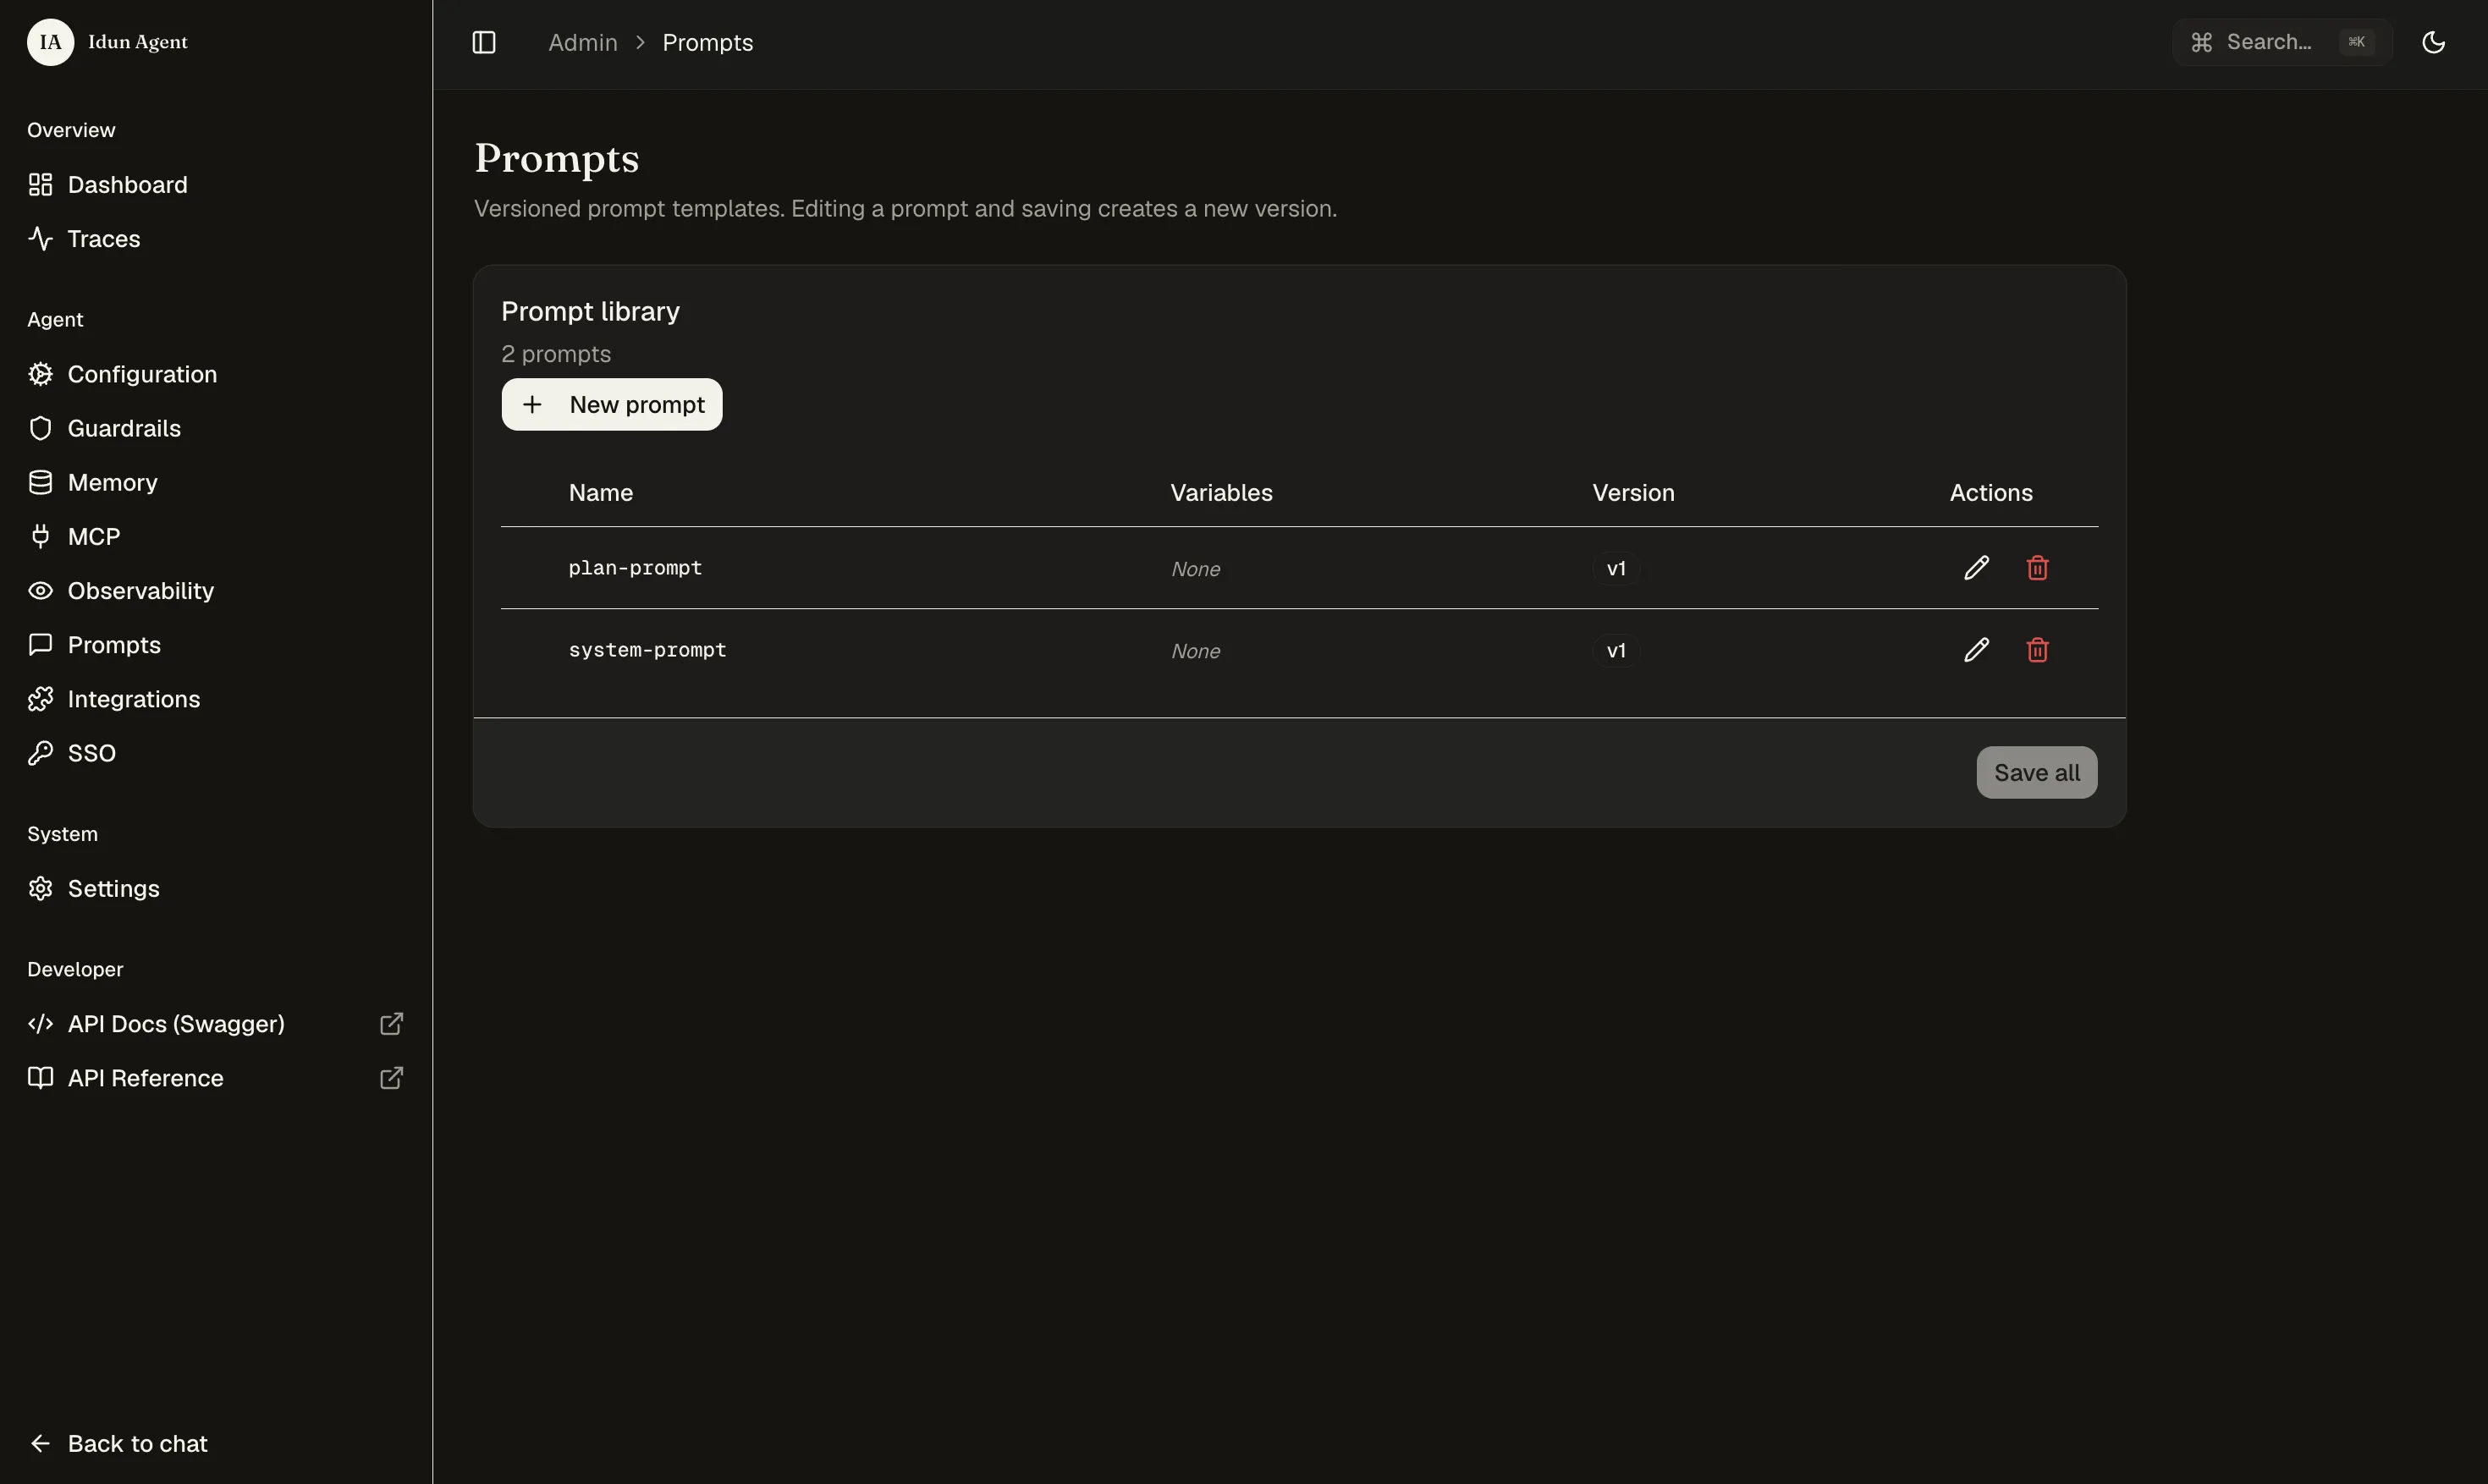
Dans l'éditeur de prompts, créez system-prompt et plan-prompt. Le templating Jinja est supporté : les variables se placent entre {{ name }} et sont remplies au runtime.
Les prompts sont scopés à l'agent : ils sont immédiatement disponibles via get_prompt(). Chaque sauvegarde crée une nouvelle version immuable.
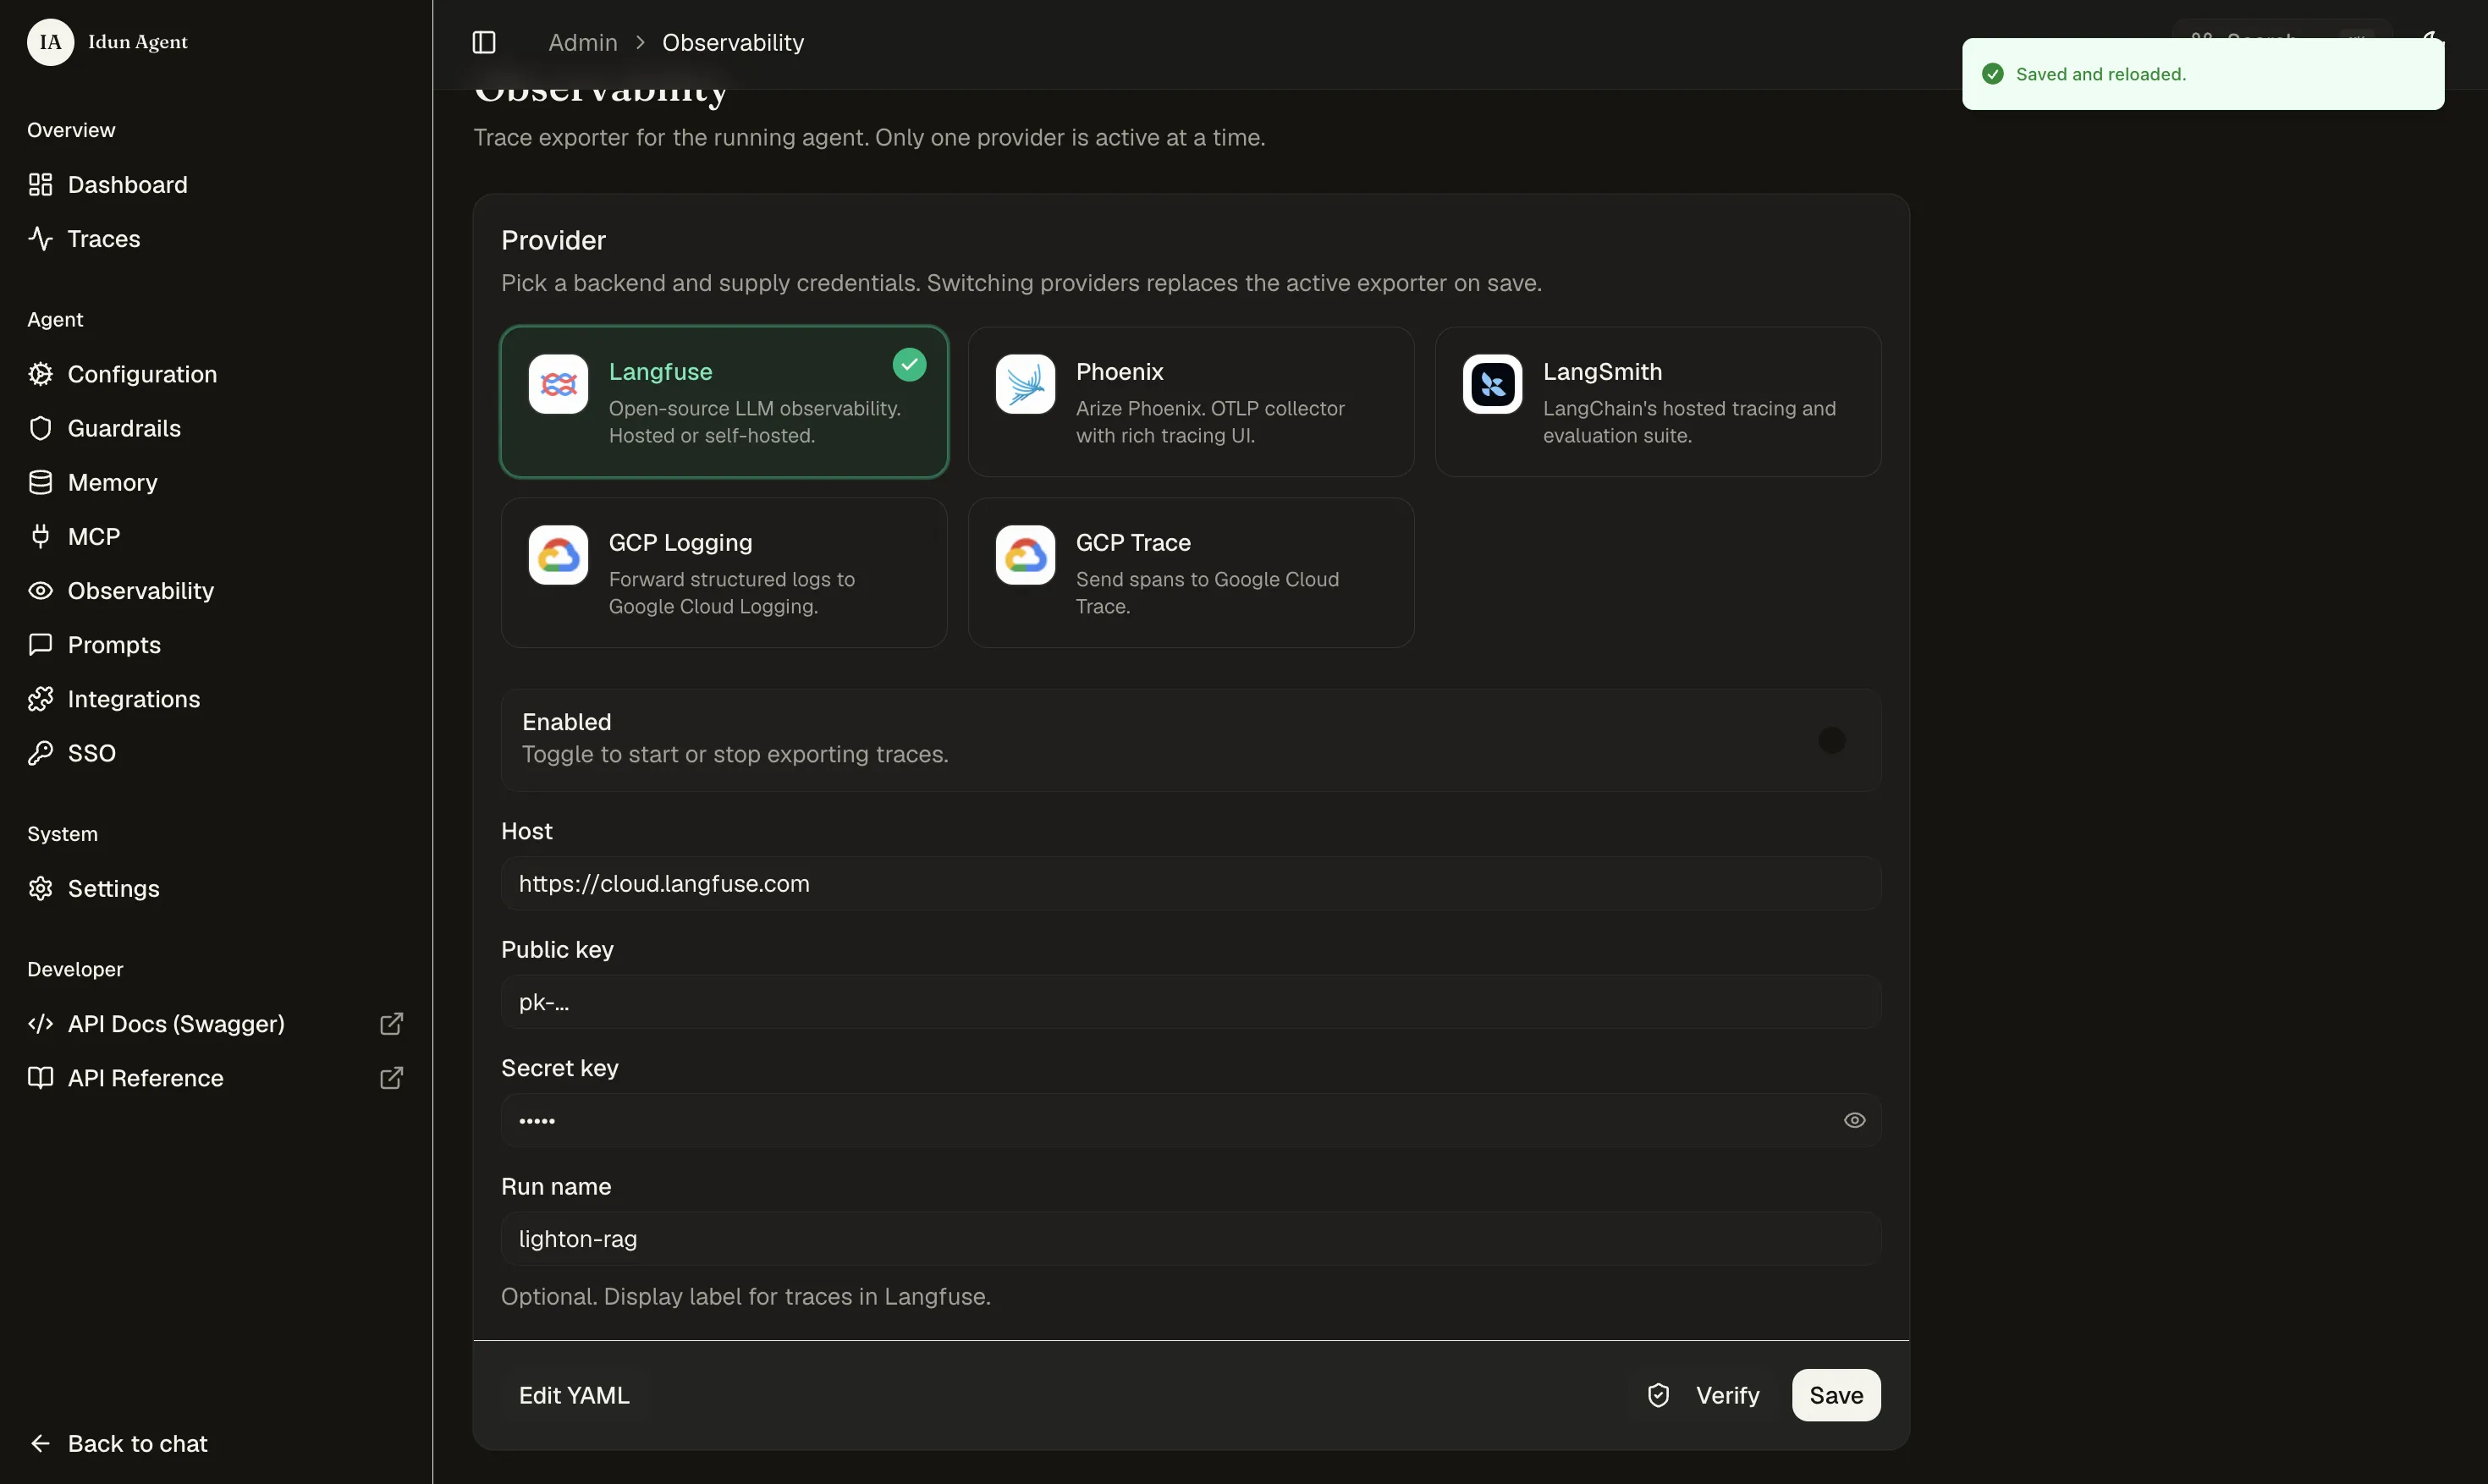
Connecter l'observabilité
Choisissez un fournisseur d'observabilité LLM (Langfuse dans notre cas) et collez les credentials.
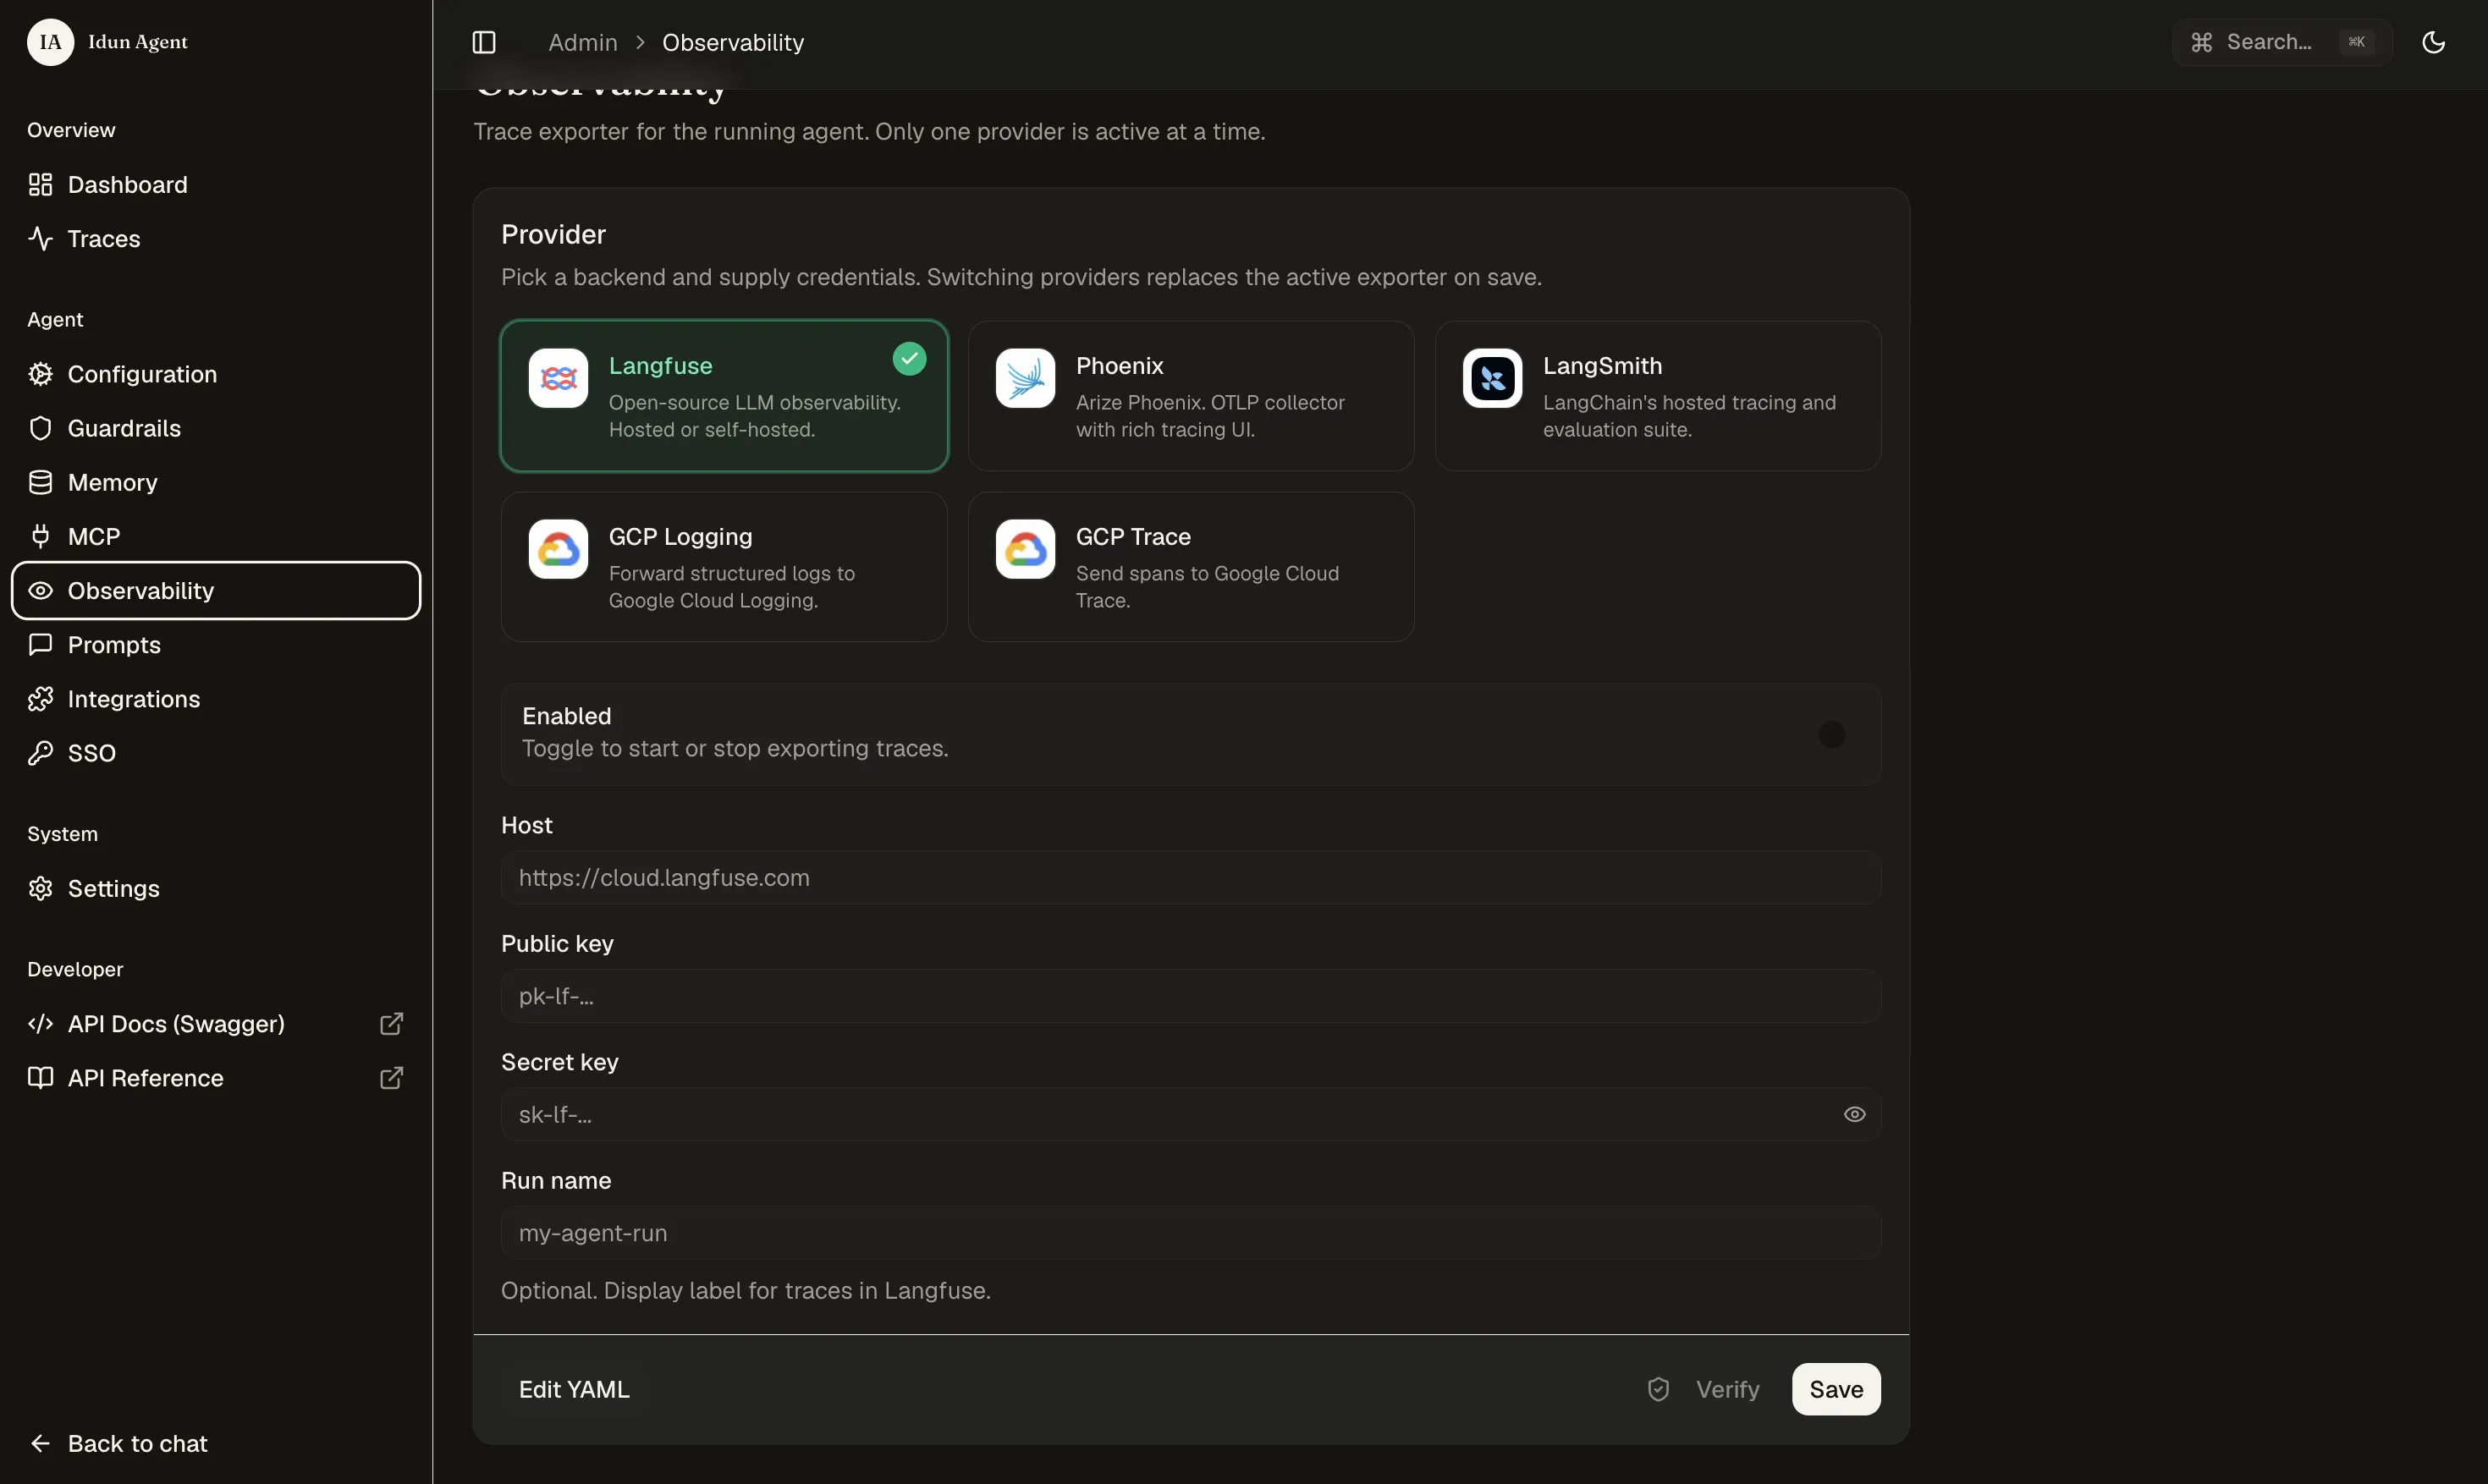
Une fois connecté, chaque tour de chaque agent remonte à Langfuse avec les traces complètes.
Ce que ça donne
On a chargé des documents RH français dans Console : contrats de travail, accords d'entreprise, politiques de télétravail, procédures disciplinaires, comptes rendus de CSE, un plan de réorganisation. Mélange de tableaux, formulaires structurés et texte libre. Les documents arrivent dans un workspace custom scopé à l'agent.
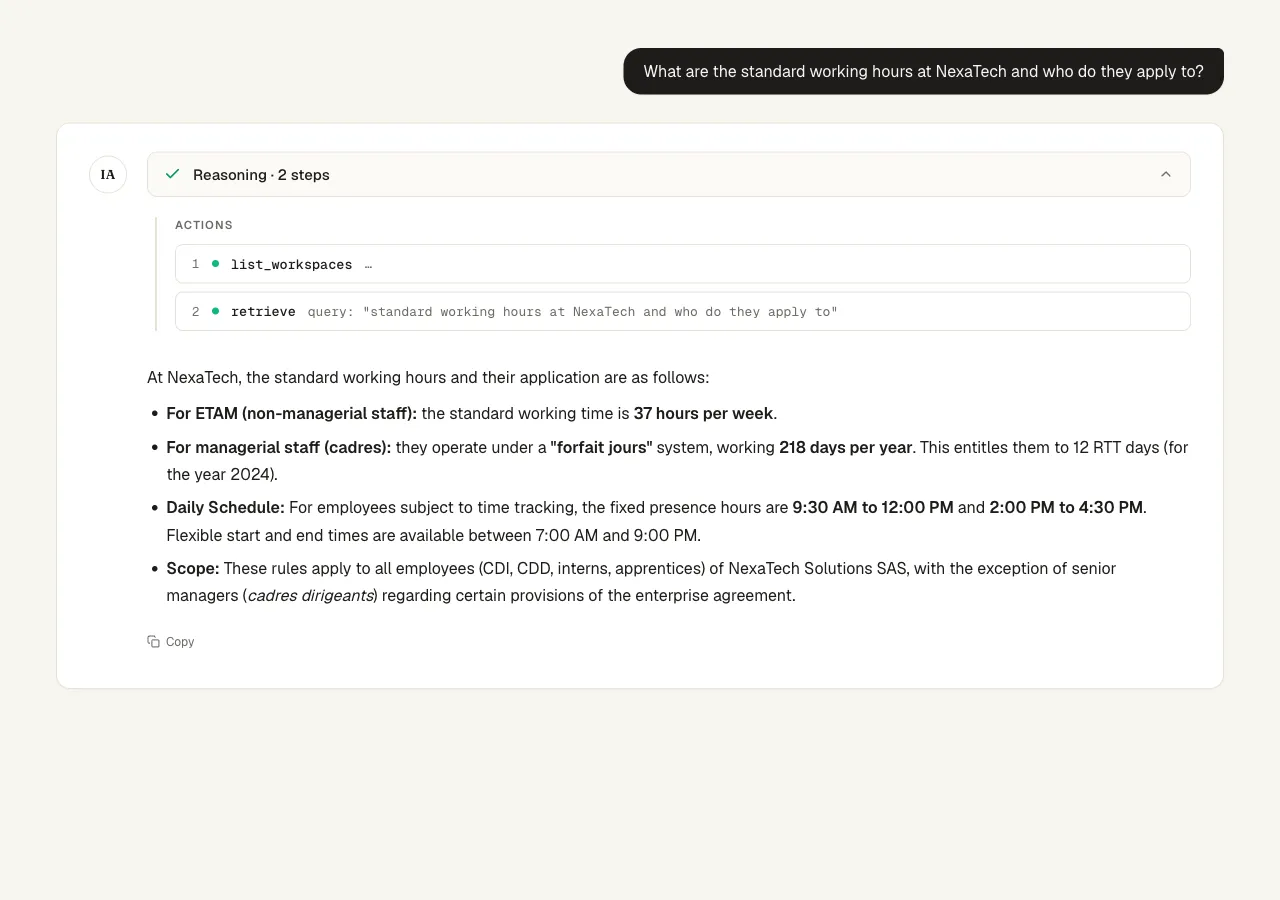
Retrieval simple. On a demandé : « Quels sont les horaires de travail standard chez NexaTech et à qui s'appliquent-ils ? »
Le planner a écrit un plan en deux étapes : appeler list_workspaces, puis retrieve avec la requête. L'executor a suivi et est revenu avec le détail : 37 heures par semaine pour les ETAM, un forfait jours de 218 jours pour les cadres avec 12 jours de RTT, plages de présence fixes de 9h30 à 12h et de 14h à 16h30 avec bornes flexibles, le tout appliqué à tous les salariés sauf les cadres dirigeants.
Raisonnement multi-documents. On a demandé : « Compare la politique de télétravail avec les résultats de satisfaction des salariés. Les salariés sont-ils contents de l'arrangement actuel ? »
L'agent a appelé list_files pour voir ce qui était disponible, identifié la politique de télétravail et le rapport trimestriel avec les données de satisfaction, puis appelé retrieve deux fois avec des requêtes ciblées, une par document. Il est revenu avec une réponse ancrée : la politique autorise jusqu'à 3 jours par semaine en télétravail ; le sondage de satisfaction donnait l'équilibre vie pro/perso à 88%, la catégorie la mieux notée. Oui, les salariés sont contents. Chaque affirmation citait le chunk source.
Questions multi-sujets. On a demandé : « Quelles procédures disciplinaires NexaTech a-t-elle en place et qui a été embauchée comme VP of Engineering ? »
Deux documents sans rapport. Le planner a écrit un plan qui couvrait les deux sujets, l'executor a interrogé la procédure disciplinaire puis le rapport interne du Q1, puis combiné les résultats. Discipline progressive couvrant avertissements, suspension et licenciement. Marie Dupont a été embauchée comme VP of Engineering, en provenance de Mistral AI. Les deux infos tirées de fichiers différents en un seul tour.
Observabilité. Chaque tour apparaît dans Langfuse avec la trace complète : prompt du planner, sortie du planner, prompt de l'executor avec le plan injecté, chaque appel d'outil avec ses arguments, chaque réponse d'outil, la réponse finale, les compteurs de tokens. Quand un tour produit une mauvaise réponse, on voit exactement où ça a déraillé : le plan était à côté, le retrieval n'a pas matché ou le LLM a ignoré un chunk.
Ce qu'on en retient
L'infrastructure qu'on n'a pas eu à construire, c'est tout l'enjeu. Zéro parsing de documents, zéro base vectorielle, zéro stratégie de chunking, zéro tuning de reranker, zéro système de contrôle d'accès. Ça, c'est Console. Zéro serveur API, zéro stockage de prompts, zéro plomberie d'observabilité, zéro couche d'authentification. Ça, c'est Idun.
Ce qu'on a vraiment écrit : un fichier d'agent avec un planner et un executor, ainsi qu'un serveur MCP qui fait le pont entre l'API de Console et le monde des agents.
LightOn Console · La plateforme open source Idun · Code source